Hot100
哈希
两数之和
给定一个整数数组 nums 和一个整数目标值 target,请你在该数组中找出 和为目标值 target 的那 两个 整数,并返回它们的数组下标。
你可以假设每种输入只会对应一个答案,并且你不能使用两次相同的元素。
你可以按任意顺序返回答案。
示例 1:
1 | 输入:nums = [2,7,11,15], target = 9 |
示例 2:
1 | 输入:nums = [3,2,4], target = 6 |
示例 3:
1 | 输入:nums = [3,3], target = 6 |
提示:
2 <= nums.length <= 104-109 <= nums[i] <= 109-109 <= target <= 109- 只会存在一个有效答案
方法一:暴力枚举
1 | class Solution { |
方法二:哈希表
1 | class Solution { |
字母异位词分组
给你一个字符串数组,请你将 字母异位词 组合在一起。可以按任意顺序返回结果列表。
示例 1:
输入: strs = [“eat”, “tea”, “tan”, “ate”, “nat”, “bat”]
输出: [[“bat”],[“nat”,”tan”],[“ate”,”eat”,”tea”]]
解释:
- 在 strs 中没有字符串可以通过重新排列来形成
"bat"。 - 字符串
"nat"和"tan"是字母异位词,因为它们可以重新排列以形成彼此。 - 字符串
"ate","eat"和"tea"是字母异位词,因为它们可以重新排列以形成彼此。
示例 2:
输入: strs = [“”]
输出: [[“”]]
示例 3:
输入: strs = [“a”]
输出: [[“a”]]
提示:
1 <= strs.length <= 1040 <= strs[i].length <= 100strs[i]仅包含小写字母
1 | class Solution { |
最长连续序列
给定一个未排序的整数数组 nums ,找出数字连续的最长序列(不要求序列元素在原数组中连续)的长度。
请你设计并实现时间复杂度为 O(n) 的算法解决此问题。
示例 1:
1 | 输入:nums = [100,4,200,1,3,2] |
示例 2:
1 | 输入:nums = [0,3,7,2,5,8,4,6,0,1] |
示例 3:
1 | 输入:nums = [1,0,1,2] |
提示:
0 <= nums.length <= 105-109 <= nums[i] <= 109
1 | class Solution { |
双指针
接雨水
给定 n 个非负整数表示每个宽度为 1 的柱子的高度图,计算按此排列的柱子,下雨之后能接多少雨水。
示例 1:
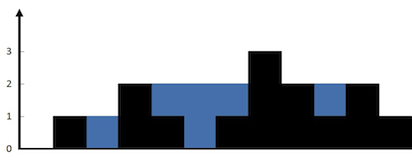
1 | 输入:height = [0,1,0,2,1,0,1,3,2,1,2,1] |
示例 2:
1 | 输入:height = [4,2,0,3,2,5] |
提示:
n == height.length1 <= n <= 2 * 1040 <= height[i] <= 105
动态规划法:
1 | class Solution { |
双指针法:
1 | class Solution { |
移动零
给定一个数组 nums,编写一个函数将所有 0 移动到数组的末尾,同时保持非零元素的相对顺序。
请注意 ,必须在不复制数组的情况下原地对数组进行操作。
示例 1:
1 | 输入: nums = [0,1,0,3,12] |
示例 2:
1 | 输入: nums = [0] |
提示:
1 <= nums.length <= 104-231 <= nums[i] <= 231 - 1
1 | class Solution { |
注意到以下性质:
- 左指针左边均为非零数;
- 右指针左边直到左指针处均为零。
盛最多水的容器
给定一个长度为 n 的整数数组 height 。有 n 条垂线,第 i 条线的两个端点是 (i, 0) 和 (i, height[i]) 。
找出其中的两条线,使得它们与 x 轴共同构成的容器可以容纳最多的水。
返回容器可以储存的最大水量。
**说明:**你不能倾斜容器。
示例 1:

1 | 输入:[1,8,6,2,5,4,8,3,7] |
示例 2:
1 | 输入:height = [1,1] |
提示:
n == height.length2 <= n <= 1050 <= height[i] <= 104
1 | class Solution { |
三数之和
给你一个整数数组 nums ,判断是否存在三元组 [nums[i], nums[j], nums[k]] 满足 i != j、i != k 且 j != k ,同时还满足 nums[i] + nums[j] + nums[k] == 0 。请你返回所有和为 0 且不重复的三元组。
**注意:**答案中不可以包含重复的三元组。
示例 1:
1 | 输入:nums = [-1,0,1,2,-1,-4] |
示例 2:
1 | 输入:nums = [0,1,1] |
示例 3:
1 | 输入:nums = [0,0,0] |
提示:
3 <= nums.length <= 3000-105 <= nums[i] <= 105
1 | public class Solution { |
滑动窗口
无重复字符的最长子串
给定一个字符串 s ,请你找出其中不含有重复字符的 最长 子串 的长度。
示例 1:
1 | 输入: s = "abcabcbb" |
示例 2:
1 | 输入: s = "bbbbb" |
示例 3:
1 | 输入: s = "pwwkew" |
提示:
0 <= s.length <= 5 * 104s由英文字母、数字、符号和空格组成
1 | class Solution { |
找到字符串中所有字母异位词
给定两个字符串 s 和 p,找到 s 中所有 p 的 异位词 的子串,返回这些子串的起始索引。不考虑答案输出的顺序。
示例 1:
1 | 输入: s = "cbaebabacd", p = "abc" |
示例 2:
1 | 输入: s = "abab", p = "ab" |
提示:
1 <= s.length, p.length <= 3 * 104s和p仅包含小写字母
1 | class Solution { |
也可使用hash来判断。
字串
和为K的子数组
给你一个整数数组 nums 和一个整数 k ,请你统计并返回 该数组中和为 k 的子数组的个数 。
子数组是数组中元素的连续非空序列。
示例 1:
1 | 输入:nums = [1,1,1], k = 2 |
示例 2:
1 | 输入:nums = [1,2,3], k = 3 |
提示:
1 <= nums.length <= 2 * 104-1000 <= nums[i] <= 1000-107 <= k <= 107
前缀和 + 哈希表优化
思路和算法
我们可以利用数据结构进行优化,我们知道对每个 i,我们需要枚举所有的 j 来判断是否符合条件,这一步是否可以优化呢?答案是可以的。
我们定义 pre[i] 为 [0..i] 里所有数的和,则 pre[i] 可以由 pre[i−1] 递推而来,即:
pre[i]=pre[i−1]+nums[i]
那么「[j..i] 这个子数组和为 k 」这个条件我们可以转化为
pre[i]−pre[j−1]==k
简单移项可得符合条件的下标 j 需要满足
pre[j−1]==pre[i]−k
所以我们考虑以 i 结尾的和为 k 的连续子数组个数时只要统计有多少个前缀和为 pre[i]−k 的 pre[j] 即可。我们建立哈希表 mp,以和为键,出现次数为对应的值,记录 pre[i] 出现的次数,从左往右边更新 mp 边计算答案,那么以 i 结尾的答案 mp[pre[i]−k] 即可在 O(1) 时间内得到。最后的答案即为所有下标结尾的和为 k 的子数组个数之和。
需要注意的是,从左往右边更新边计算的时候已经保证了mp[pre[i]−k] 里记录的 pre[j] 的下标范围是 0≤j≤i 。同时,由于pre[i] 的计算只与前一项的答案有关,因此我们可以不用建立 pre 数组,直接用 pre 变量来记录 pre[i−1] 的答案即可。
1 | public class Solution { |
滑动窗口最大值
给你一个整数数组 nums,有一个大小为 k 的滑动窗口从数组的最左侧移动到数组的最右侧。你只可以看到在滑动窗口内的 k 个数字。滑动窗口每次只向右移动一位。
返回 滑动窗口中的最大值 。
示例 1:
1 | 输入:nums = [1,3,-1,-3,5,3,6,7], k = 3 |
示例 2:
1 | 输入:nums = [1], k = 1 |
提示:
1 <= nums.length <= 105-104 <= nums[i] <= 1041 <= k <= nums.length
单调队列:
1 | class Solution { |
双端队列的作用:队列中存储的是数组索引,且对应的值从队头到队尾单调递减。这样队头永远是当前窗口的最大值索引。
维护队列的两个关键操作:
- 入队前清理:新元素入队时,移除队列尾部所有比它小的元素(因为这些元素不可能成为后续窗口的最大值),保证队列单调递减。
- 出队清理:移除队列头部超出当前窗口范围的索引(窗口滑动后,旧的最大值不在窗口内了)。
窗口滑动:每滑动一次,就将当前队头对应的数值加入结果数组。
除了基于「随着窗口的移动实时维护最大值」的方法一以及方法二之外,我们还可以考虑其他有趣的做法。
分块+预处理:
1 | class Solution { |
最小覆盖子串
给定两个字符串 s 和 t,长度分别是 m 和 n,返回 s 中的 最短窗口 子串,使得该子串包含 t 中的每一个字符(包括重复字符)。如果没有这样的子串,返回空字符串 ""。
测试用例保证答案唯一。
示例 1:
1 | 输入:s = "ADOBECODEBANC", t = "ABC" |
示例 2:
1 | 输入:s = "a", t = "a" |
示例 3:
1 | 输入: s = "a", t = "aa" |
提示:
m == s.lengthn == t.length1 <= m, n <= 105s和t由英文字母组成
1 | class Solution { |
普通数组
最大子数组和
给你一个整数数组 nums ,请你找出一个具有最大和的连续子数组(子数组最少包含一个元素),返回其最大和。
子数组是数组中的一个连续部分。
示例 1:
1 | 输入:nums = [-2,1,-3,4,-1,2,1,-5,4] |
示例 2:
1 | 输入:nums = [1] |
示例 3:
1 | 输入:nums = [5,4,-1,7,8] |
提示:
1 <= nums.length <= 105-104 <= nums[i] <= 104
1 | class Solution { |
合并区间
以数组 intervals 表示若干个区间的集合,其中单个区间为 intervals[i] = [starti, endi] 。请你合并所有重叠的区间,并返回 一个不重叠的区间数组,该数组需恰好覆盖输入中的所有区间 。
示例 1:
1 | 输入:intervals = [[1,3],[2,6],[8,10],[15,18]] |
示例 2:
1 | 输入:intervals = [[1,4],[4,5]] |
示例 3:
1 | 输入:intervals = [[4,7],[1,4]] |
提示:
1 <= intervals.length <= 104intervals[i].length == 20 <= starti <= endi <= 104
1 | class Solution { |
轮转数组
给定一个整数数组 nums,将数组中的元素向右轮转 k 个位置,其中 k 是非负数。
示例 1:
1 | 输入: nums = [1,2,3,4,5,6,7], k = 3 |
示例 2:
1 | 输入:nums = [-1,-100,3,99], k = 2 |
提示:
1 <= nums.length <= 105-231 <= nums[i] <= 231 - 10 <= k <= 105
1 | class Solution { |
除自身以外数组的乘积
给你一个整数数组 nums,返回 数组 answer ,其中 answer[i] 等于 nums 中除了 nums[i] 之外其余各元素的乘积 。
题目数据 保证 数组 nums之中任意元素的全部前缀元素和后缀的乘积都在 32 位 整数范围内。
请 **不要使用除法,**且在 O(n) 时间复杂度内完成此题。
示例 1:
1 | 输入: nums = [1,2,3,4] |
示例 2:
1 | 输入: nums = [-1,1,0,-3,3] |
提示:
2 <= nums.length <= 105-30 <= nums[i] <= 30- 输入 保证 数组
answer[i]在 32 位 整数范围内
1 | class Solution { |
缺失的第一个整数
给你一个未排序的整数数组 nums ,请你找出其中没有出现的最小的正整数。
请你实现时间复杂度为 O(n) 并且只使用常数级别额外空间的解决方案。
示例 1:
1 | 输入:nums = [1,2,0] |
示例 2:
1 | 输入:nums = [3,4,-1,1] |
示例 3:
1 | 输入:nums = [7,8,9,11,12] |
提示:
1 <= nums.length <= 105-231 <= nums[i] <= 231 - 1
1 | class Solution { |
矩阵
矩阵置零
给定一个 *m* x *n* 的矩阵,如果一个元素为 0 ,则将其所在行和列的所有元素都设为 0 。请使用 原地 算法**。**
示例 1:
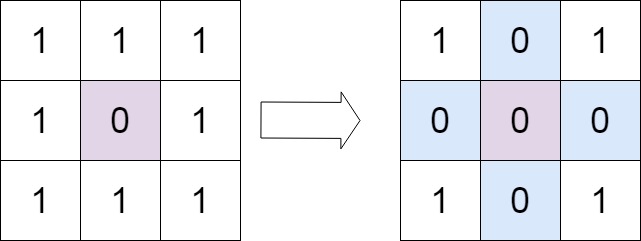
1 | 输入:matrix = [[1,1,1],[1,0,1],[1,1,1]] |
示例 2:
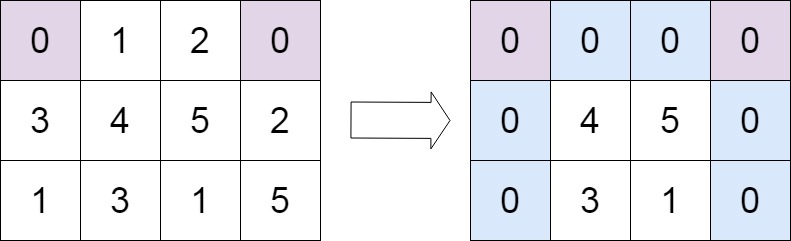
1 | 输入:matrix = [[0,1,2,0],[3,4,5,2],[1,3,1,5]] |
提示:
m == matrix.lengthn == matrix[0].length1 <= m, n <= 200-231 <= matrix[i][j] <= 231 - 1
1 | class Solution { |
螺旋矩阵
给你一个 m 行 n 列的矩阵 matrix ,请按照 顺时针螺旋顺序 ,返回矩阵中的所有元素。
示例 1:
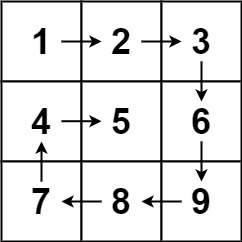
1 | 输入:matrix = [[1,2,3],[4,5,6],[7,8,9]] |
示例 2:

1 | 输入:matrix = [[1,2,3,4],[5,6,7,8],[9,10,11,12]] |
提示:
m == matrix.lengthn == matrix[i].length1 <= m, n <= 10-100 <= matrix[i][j] <= 100
1 | class Solution { |
旋转图像
给定一个 n × n 的二维矩阵 matrix 表示一个图像。请你将图像顺时针旋转 90 度。
你必须在** 原地** 旋转图像,这意味着你需要直接修改输入的二维矩阵。请不要 使用另一个矩阵来旋转图像。
示例 1:
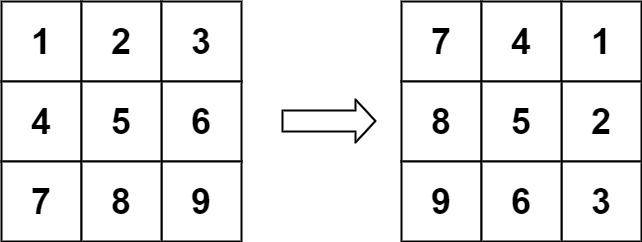
1 | 输入:matrix = [[1,2,3],[4,5,6],[7,8,9]] |
示例 2:
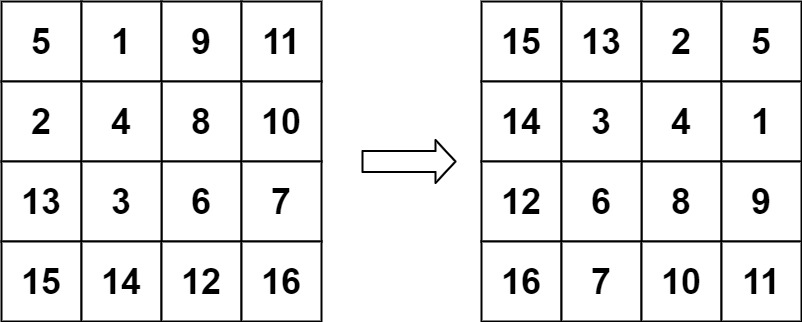
1 | 输入:matrix = [[5,1,9,11],[2,4,8,10],[13,3,6,7],[15,14,12,16]] |
提示:
n == matrix.length == matrix[i].length1 <= n <= 20-1000 <= matrix[i][j] <= 1000
1 | class Solution { |
对于矩阵中第 i 行的第 j 个元素,在旋转后,它出现在倒数第 i 列的第 j 个位置。
搜索二维矩阵II
编写一个高效的算法来搜索 *m* x *n* 矩阵 matrix 中的一个目标值 target 。该矩阵具有以下特性:
- 每行的元素从左到右升序排列。
- 每列的元素从上到下升序排列。
示例 1:
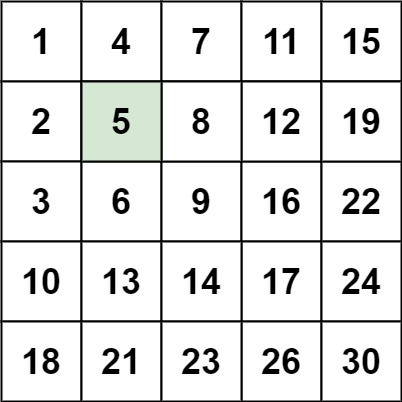
1 | 输入:matrix = [[1,4,7,11,15],[2,5,8,12,19],[3,6,9,16,22],[10,13,14,17,24],[18,21,23,26,30]], target = 5 |
示例 2:
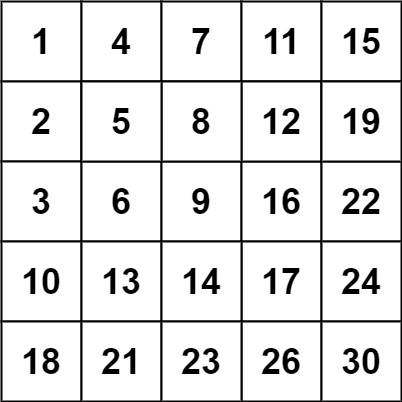
1 | 输入:matrix = [[1,4,7,11,15],[2,5,8,12,19],[3,6,9,16,22],[10,13,14,17,24],[18,21,23,26,30]], target = 20 |
提示:
m == matrix.lengthn == matrix[i].length1 <= n, m <= 300-109 <= matrix[i][j] <= 109- 每行的所有元素从左到右升序排列
- 每列的所有元素从上到下升序排列
-109 <= target <= 109
1 | class Solution { |
链表
相交链表
给你两个单链表的头节点 headA 和 headB ,请你找出并返回两个单链表相交的起始节点。如果两个链表不存在相交节点,返回 null 。
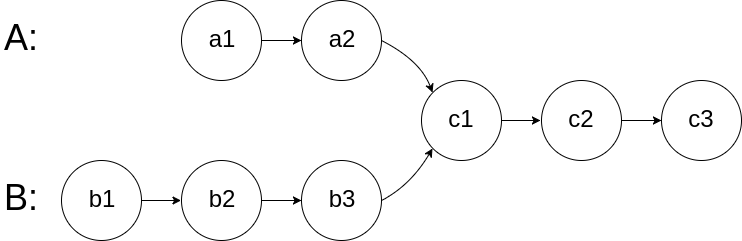
图示两个链表在节点 c1 开始相交**:**
题目数据 保证 整个链式结构中不存在环。
注意,函数返回结果后,链表必须 保持其原始结构 。
自定义评测:
评测系统 的输入如下(你设计的程序 不适用 此输入):
intersectVal- 相交的起始节点的值。如果不存在相交节点,这一值为0listA- 第一个链表listB- 第二个链表skipA- 在listA中(从头节点开始)跳到交叉节点的节点数skipB- 在listB中(从头节点开始)跳到交叉节点的节点数
评测系统将根据这些输入创建链式数据结构,并将两个头节点 headA 和 headB 传递给你的程序。如果程序能够正确返回相交节点,那么你的解决方案将被 视作正确答案 。
示例 1:
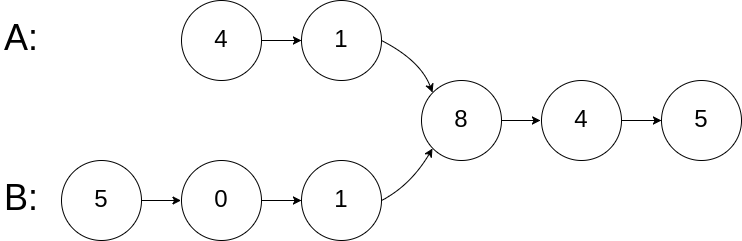
1 | 输入:intersectVal = 8, listA = [4,1,8,4,5], listB = [5,6,1,8,4,5], skipA = 2, skipB = 3 |
示例 2:
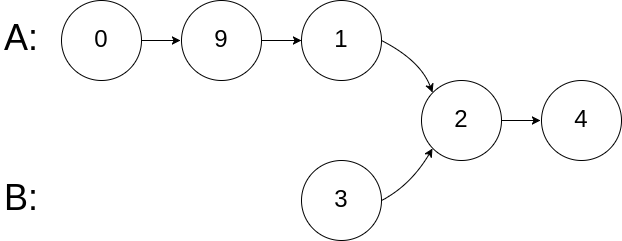
1 | 输入:intersectVal = 2, listA = [1,9,1,2,4], listB = [3,2,4], skipA = 3, skipB = 1 |
示例 3:
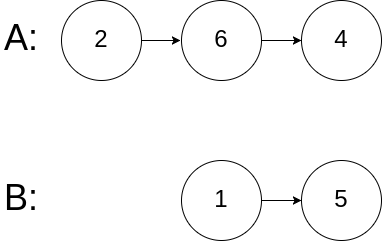
1 | 输入:intersectVal = 0, listA = [2,6,4], listB = [1,5], skipA = 3, skipB = 2 |
提示:
listA中节点数目为mlistB中节点数目为n1 <= m, n <= 3 * 1041 <= Node.val <= 1050 <= skipA <= m0 <= skipB <= n- 如果
listA和listB没有交点,intersectVal为0 - 如果
listA和listB有交点,intersectVal == listA[skipA] == listB[skipB]
1 | public class Solution { |
情况一:两个链表相交
链表 headA 和 headB 的长度分别是 m 和 n。假设链表 headA 的不相交部分有 a 个节点,链表 headB 的不相交部分有 b 个节点,两个链表相交的部分有 c 个节点,则有 a+c=m,b+c=n。
如果 a=b,则两个指针会同时到达两个链表相交的节点,此时返回相交的节点;
如果 a\=b,则指针 pA 会遍历完链表 headA,指针 pB 会遍历完链表 headB,两个指针不会同时到达链表的尾节点,然后指针 pA 移到链表 headB 的头节点,指针 pB 移到链表 headA 的头节点,然后两个指针继续移动,在指针 pA 移动了 a+c+b 次、指针 pB 移动了 b+c+a 次之后,两个指针会同时到达两个链表相交的节点,该节点也是两个指针第一次同时指向的节点,此时返回相交的节点。
情况二:两个链表不相交
链表 headA 和 headB 的长度分别是 m 和 n。考虑当 m=n 和 m\=n 时,两个指针分别会如何移动:
如果 m=n,则两个指针会同时到达两个链表的尾节点,然后同时变成空值 null,此时返回 null;
如果 m\=n,则由于两个链表没有公共节点,两个指针也不会同时到达两个链表的尾节点,因此两个指针都会遍历完两个链表,在指针 pA 移动了 m+n 次、指针 pB 移动了 n+m 次之后,两个指针会同时变成空值 null,此时返回 null。
反转链表
给你单链表的头节点 head ,请你反转链表,并返回反转后的链表。
示例 1:

1 | 输入:head = [1,2,3,4,5] |
示例 2:

1 | 输入:head = [1,2] |
示例 3:
1 | 输入:head = [] |
提示:
- 链表中节点的数目范围是
[0, 5000] -5000 <= Node.val <= 5000
1 | class Solution { |
回文链表
给你一个单链表的头节点 head ,请你判断该链表是否为回文链表。如果是,返回 true ;否则,返回 false 。
示例 1:
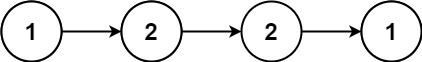
1 | 输入:head = [1,2,2,1] |
示例 2:
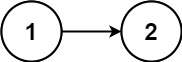
1 | 输入:head = [1,2] |
提示:
- 链表中节点数目在范围
[1, 105]内 0 <= Node.val <= 9
快慢指针:
1 | class Solution { |
环形链表
给你一个链表的头节点 head ,判断链表中是否有环。
如果链表中有某个节点,可以通过连续跟踪 next 指针再次到达,则链表中存在环。 为了表示给定链表中的环,评测系统内部使用整数 pos 来表示链表尾连接到链表中的位置(索引从 0 开始)。注意:pos 不作为参数进行传递 。仅仅是为了标识链表的实际情况。
如果链表中存在环 ,则返回 true 。 否则,返回 false 。
示例 1:
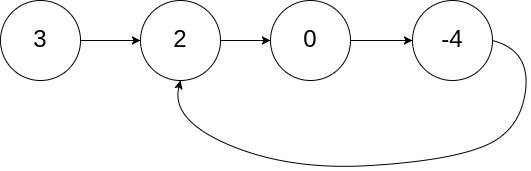
1 | 输入:head = [3,2,0,-4], pos = 1 |
示例 2:
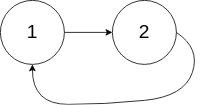
1 | 输入:head = [1,2], pos = 0 |
示例 3:

1 | 输入:head = [1], pos = -1 |
提示:
- 链表中节点的数目范围是
[0, 104] -105 <= Node.val <= 105pos为-1或者链表中的一个 有效索引 。
哈希表
1 | public class Solution { |
快慢指针
1 | public class Solution { |
环形链表II
给定一个链表的头节点 head ,返回链表开始入环的第一个节点。 如果链表无环,则返回 null。
如果链表中有某个节点,可以通过连续跟踪 next 指针再次到达,则链表中存在环。 为了表示给定链表中的环,评测系统内部使用整数 pos 来表示链表尾连接到链表中的位置(索引从 0 开始)。如果 pos 是 -1,则在该链表中没有环。注意:pos 不作为参数进行传递,仅仅是为了标识链表的实际情况。
不允许修改 链表。
示例 1:
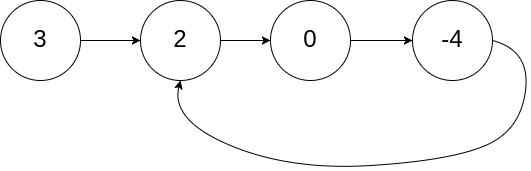
1 | 输入:head = [3,2,0,-4], pos = 1 |
示例 2:
1 | 输入:head = [1,2], pos = 0 |
示例 3:
1 | 输入:head = [1], pos = -1 |
提示:
- 链表中节点的数目范围在范围
[0, 104]内 -105 <= Node.val <= 105pos的值为-1或者链表中的一个有效索引
1 | public class Solution { |
合并两个有序列表
将两个升序链表合并为一个新的 升序 链表并返回。新链表是通过拼接给定的两个链表的所有节点组成的。
示例 1:
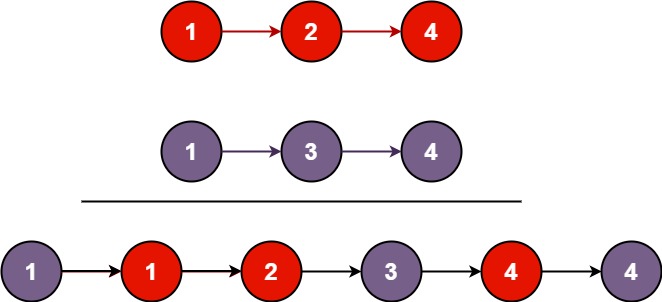
1 | 输入:l1 = [1,2,4], l2 = [1,3,4] |
示例 2:
1 | 输入:l1 = [], l2 = [] |
示例 3:
1 | 输入:l1 = [], l2 = [0] |
提示:
- 两个链表的节点数目范围是
[0, 50] -100 <= Node.val <= 100l1和l2均按 非递减顺序 排列
1 | class Solution { |
两数相加
给你两个 非空 的链表,表示两个非负的整数。它们每位数字都是按照 逆序 的方式存储的,并且每个节点只能存储 一位 数字。
请你将两个数相加,并以相同形式返回一个表示和的链表。
你可以假设除了数字 0 之外,这两个数都不会以 0 开头。
示例 1:
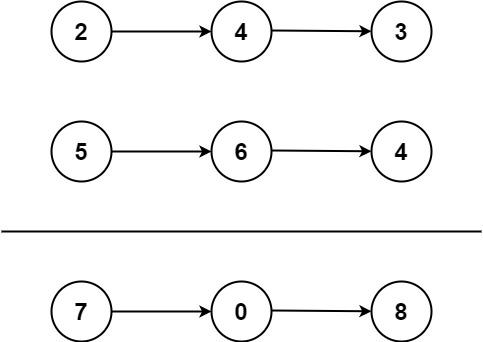
1 | 输入:l1 = [2,4,3], l2 = [5,6,4] |
示例 2:
1 | 输入:l1 = [0], l2 = [0] |
示例 3:
1 | 输入:l1 = [9,9,9,9,9,9,9], l2 = [9,9,9,9] |
提示:
- 每个链表中的节点数在范围
[1, 100]内 0 <= Node.val <= 9- 题目数据保证列表表示的数字不含前导零
1 | class Solution { |
删除链表的倒数第N个节点
给你一个链表,删除链表的倒数第 n 个结点,并且返回链表的头结点。
示例 1:
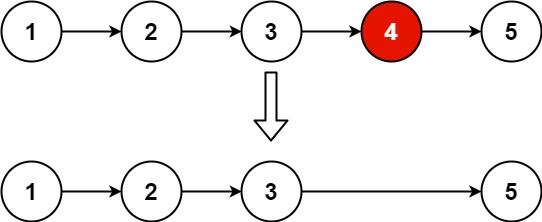
1 | 输入:head = [1,2,3,4,5], n = 2 |
示例 2:
1 | 输入:head = [1], n = 1 |
示例 3:
1 | 输入:head = [1,2], n = 1 |
提示:
- 链表中结点的数目为
sz 1 <= sz <= 300 <= Node.val <= 1001 <= n <= sz
1 | class Solution { |
两两交换链表中的节点
给你一个链表,两两交换其中相邻的节点,并返回交换后链表的头节点。你必须在不修改节点内部的值的情况下完成本题(即,只能进行节点交换)。
示例 1:
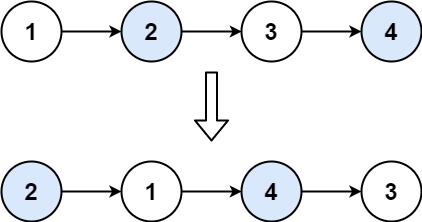
1 | 输入:head = [1,2,3,4] |
示例 2:
1 | 输入:head = [] |
示例 3:
1 | 输入:head = [1] |
提示:
- 链表中节点的数目在范围
[0, 100]内 0 <= Node.val <= 100
1 | class Solution { |
K个一组翻转链表
给你链表的头节点 head ,每 k 个节点一组进行翻转,请你返回修改后的链表。
k 是一个正整数,它的值小于或等于链表的长度。如果节点总数不是 k 的整数倍,那么请将最后剩余的节点保持原有顺序。
你不能只是单纯的改变节点内部的值,而是需要实际进行节点交换。
示例 1:
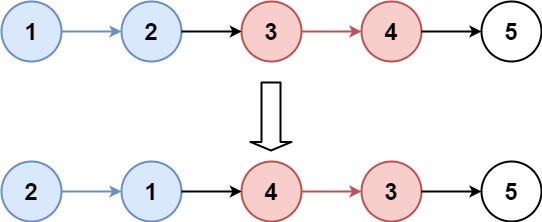
1 | 输入:head = [1,2,3,4,5], k = 2 |
示例 2:
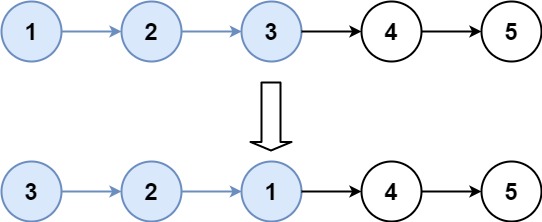
1 | 输入:head = [1,2,3,4,5], k = 3 |
提示:
- 链表中的节点数目为
n 1 <= k <= n <= 50000 <= Node.val <= 1000
1 | class Solution { |
随即链表的复制
给你一个长度为 n 的链表,每个节点包含一个额外增加的随机指针 random ,该指针可以指向链表中的任何节点或空节点。
构造这个链表的 深拷贝。 深拷贝应该正好由 n 个 全新 节点组成,其中每个新节点的值都设为其对应的原节点的值。新节点的 next 指针和 random 指针也都应指向复制链表中的新节点,并使原链表和复制链表中的这些指针能够表示相同的链表状态。复制链表中的指针都不应指向原链表中的节点 。
例如,如果原链表中有 X 和 Y 两个节点,其中 X.random --> Y 。那么在复制链表中对应的两个节点 x 和 y ,同样有 x.random --> y 。
返回复制链表的头节点。
用一个由 n 个节点组成的链表来表示输入/输出中的链表。每个节点用一个 [val, random_index] 表示:
val:一个表示Node.val的整数。random_index:随机指针指向的节点索引(范围从0到n-1);如果不指向任何节点,则为null。
你的代码 只 接受原链表的头节点 head 作为传入参数。
示例 1:
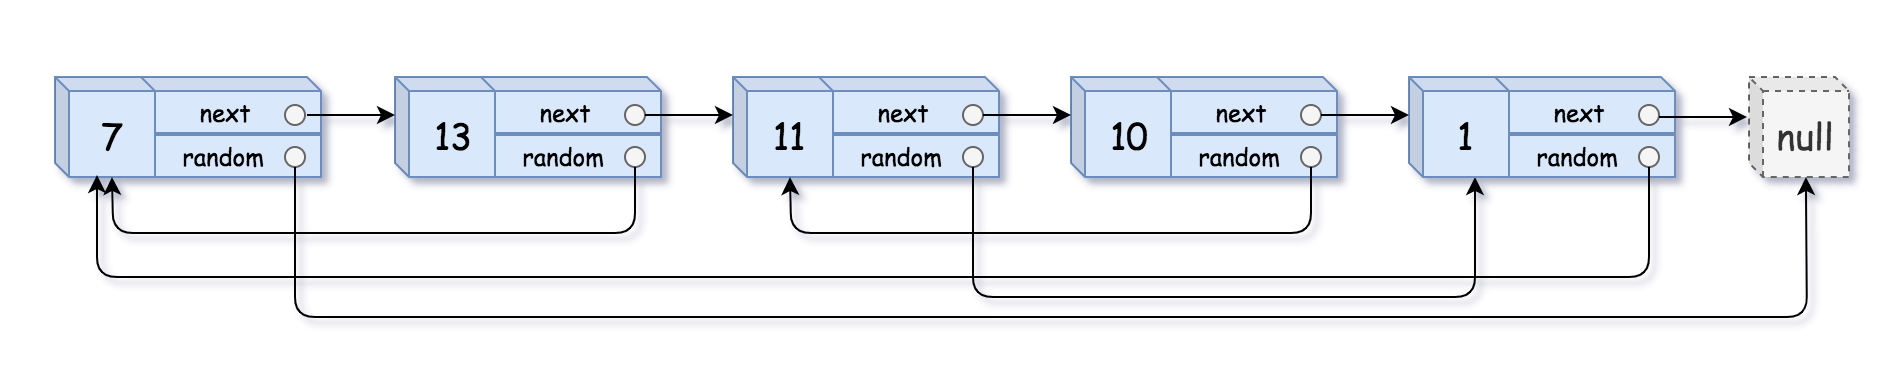
1 | 输入:head = [[7,null],[13,0],[11,4],[10,2],[1,0]] |
示例 2:
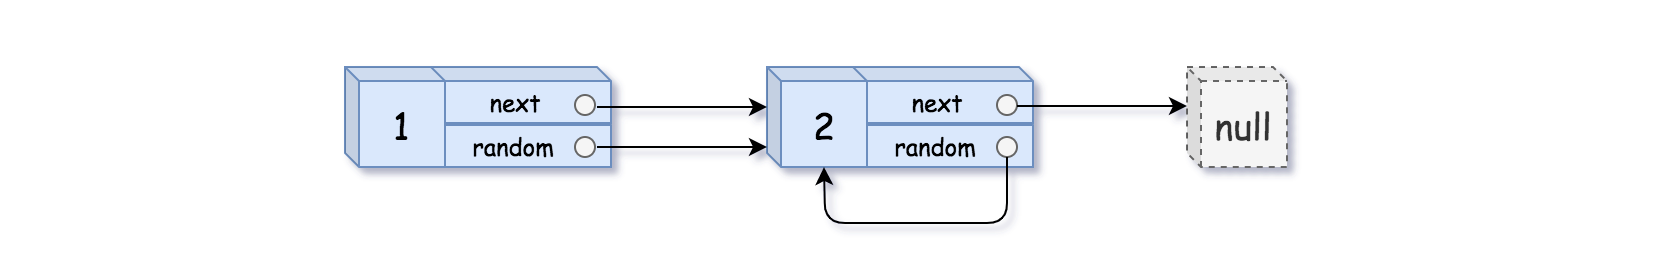
1 | 输入:head = [[1,1],[2,1]] |
示例 3:

1 | 输入:head = [[3,null],[3,0],[3,null]] |
提示:
0 <= n <= 1000-104 <= Node.val <= 104Node.random为null或指向链表中的节点。
1 | class Solution { |
排序链表
给你链表的头结点 head ,请将其按 升序 排列并返回 排序后的链表 。
示例 1:
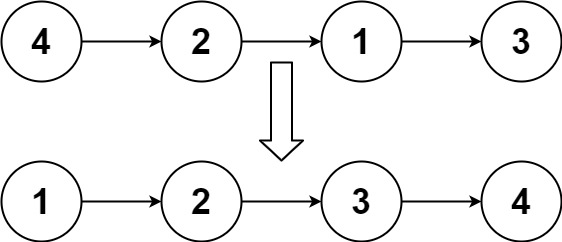
1 | 输入:head = [4,2,1,3] |
示例 2:

1 | 输入:head = [-1,5,3,4,0] |
示例 3:
1 | 输入:head = [] |
提示:
- 链表中节点的数目在范围
[0, 5 * 104]内 -105 <= Node.val <= 105
巧妙:
1 | class Solution { |
暴力:
1 | class Solution { |
合并K个升序链表
给你一个链表数组,每个链表都已经按升序排列。
请你将所有链表合并到一个升序链表中,返回合并后的链表。
示例 1:
1 | 输入:lists = [[1,4,5],[1,3,4],[2,6]] |
示例 2:
1 | 输入:lists = [] |
示例 3:
1 | 输入:lists = [[]] |
提示:
k == lists.length0 <= k <= 10^40 <= lists[i].length <= 500-10^4 <= lists[i][j] <= 10^4lists[i]按 升序 排列lists[i].length的总和不超过10^4
暴力
1 | class Solution { |
分治合并
1 | class Solution { |
LRU缓存
请你设计并实现一个满足 LRU (最近最少使用) 缓存 约束的数据结构。
实现 LRUCache 类:
LRUCache(int capacity)以 正整数 作为容量capacity初始化 LRU 缓存int get(int key)如果关键字key存在于缓存中,则返回关键字的值,否则返回-1。void put(int key, int value)如果关键字key已经存在,则变更其数据值value;如果不存在,则向缓存中插入该组key-value。如果插入操作导致关键字数量超过capacity,则应该 逐出 最久未使用的关键字。
函数 get 和 put 必须以 O(1) 的平均时间复杂度运行。
示例:
1 | 输入 |
提示:
1 <= capacity <= 30000 <= key <= 100000 <= value <= 105- 最多调用
2 * 105次get和put
1 | public class LRUCache { |
二叉树
二叉树的中序遍历
给定一个二叉树的根节点 root ,返回 它的 中序 遍历 。
示例 1:
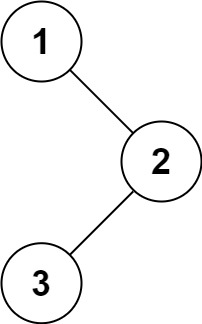
1 | 输入:root = [1,null,2,3] |
示例 2:
1 | 输入:root = [] |
示例 3:
1 | 输入:root = [1] |
提示:
- 树中节点数目在范围
[0, 100]内 -100 <= Node.val <= 100
1 | class Solution { |
二叉树的最大深度
给定一个二叉树 root ,返回其最大深度。
二叉树的 最大深度 是指从根节点到最远叶子节点的最长路径上的节点数。
示例 1:
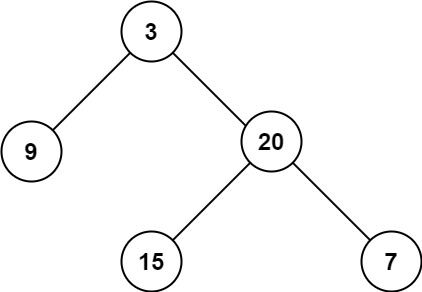
1 | 输入:root = [3,9,20,null,null,15,7] |
示例 2:
1 | 输入:root = [1,null,2] |
提示:
- 树中节点的数量在
[0, 104]区间内。 -100 <= Node.val <= 100
1 | class Solution { |
翻转二叉树
给你一棵二叉树的根节点 root ,翻转这棵二叉树,并返回其根节点。
示例 1:
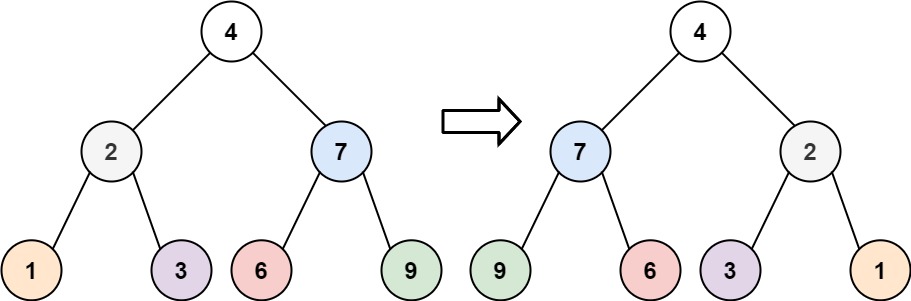
1 | 输入:root = [4,2,7,1,3,6,9] |
示例 2:
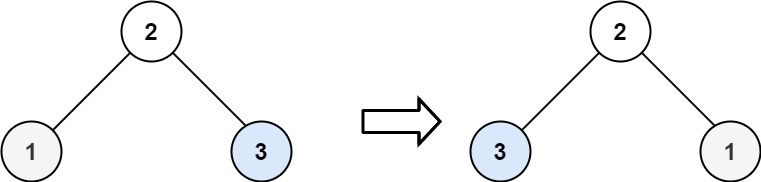
1 | 输入:root = [2,1,3] |
示例 3:
1 | 输入:root = [] |
提示:
- 树中节点数目范围在
[0, 100]内 -100 <= Node.val <= 100
1 | class Solution { |
对称二叉树
给你一个二叉树的根节点 root , 检查它是否轴对称。
示例 1:
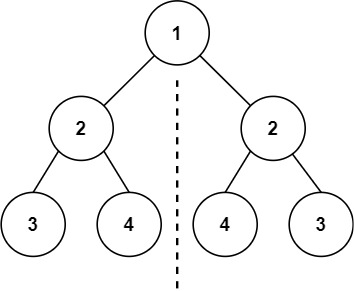
1 | 输入:root = [1,2,2,3,4,4,3] |
示例 2:
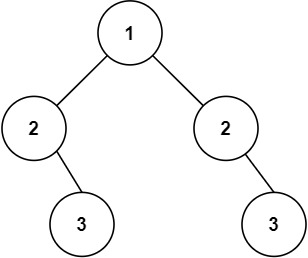
1 | 输入:root = [1,2,2,null,3,null,3] |
提示:
- 树中节点数目在范围
[1, 1000]内 -100 <= Node.val <= 100
1 | class Solution { |
二叉树的直径
给你一棵二叉树的根节点,返回该树的 直径 。
二叉树的 直径 是指树中任意两个节点之间最长路径的 长度 。这条路径可能经过也可能不经过根节点 root 。
两节点之间路径的 长度 由它们之间边数表示。
示例 1:
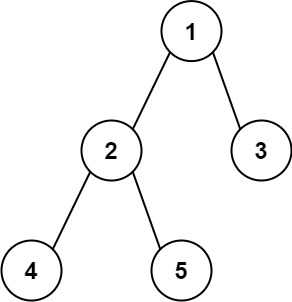
1 | 输入:root = [1,2,3,4,5] |
示例 2:
1 | 输入:root = [1,2] |
提示:
- 树中节点数目在范围
[1, 104]内 -100 <= Node.val <= 100
1 | class Solution { |
二叉树的层序遍历
给你二叉树的根节点 root ,返回其节点值的 层序遍历 。 (即逐层地,从左到右访问所有节点)。
示例 1:
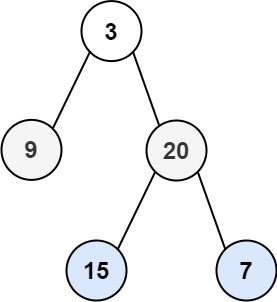
1 | 输入:root = [3,9,20,null,null,15,7] |
示例 2:
1 | 输入:root = [1] |
示例 3:
1 | 输入:root = [] |
提示:
- 树中节点数目在范围
[0, 2000]内 -1000 <= Node.val <= 1000
1 | class Solution { |
将有序数组转化为二叉搜索树
给你一个整数数组 nums ,其中元素已经按 升序 排列,请你将其转换为一棵 平衡 二叉搜索树。
示例 1:
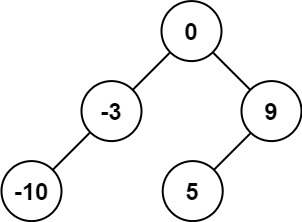
1 | 输入:nums = [-10,-3,0,5,9] |
示例 2:
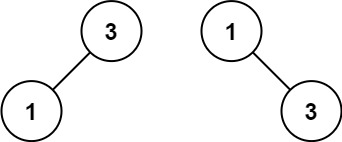
1 | 输入:nums = [1,3] |
提示:
1 <= nums.length <= 104-104 <= nums[i] <= 104nums按 严格递增 顺序排列
1 | class Solution { |
验证二叉搜索树
给你一个二叉树的根节点 root ,判断其是否是一个有效的二叉搜索树。
有效 二叉搜索树定义如下:
- 节点的左子树只包含 严格小于 当前节点的数。
- 节点的右子树只包含 严格大于 当前节点的数。
- 所有左子树和右子树自身必须也是二叉搜索树。
示例 1:

1 | 输入:root = [2,1,3] |
示例 2:

1 | 输入:root = [5,1,4,null,null,3,6] |
提示:
- 树中节点数目范围在
[1, 104]内 -231 <= Node.val <= 231 - 1
1 | class Solution { |
二叉搜索树中第K小的元素
给定一个二叉搜索树的根节点 root ,和一个整数 k ,请你设计一个算法查找其中第 k 小的元素(k 从 1 开始计数)。
示例 1:
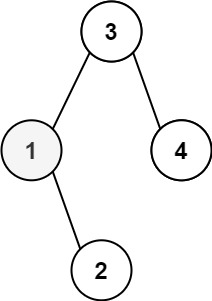
1 | 输入:root = [3,1,4,null,2], k = 1 |
示例 2:
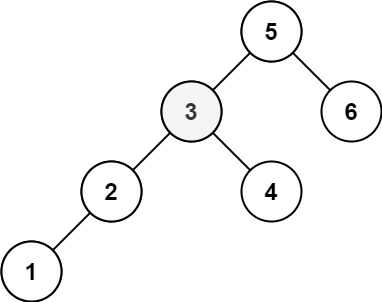
1 | 输入:root = [5,3,6,2,4,null,null,1], k = 3 |
提示:
- 树中的节点数为
n。 1 <= k <= n <= 1040 <= Node.val <= 104
1 | class Solution { |
二叉树的右视图
给定一个二叉树的 根节点 root,想象自己站在它的右侧,按照从顶部到底部的顺序,返回从右侧所能看到的节点值。
示例 1:
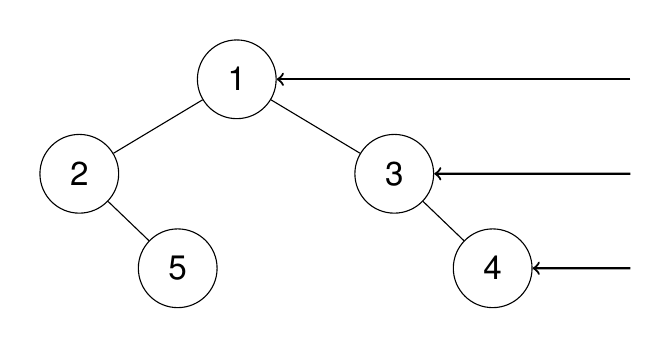
**输入:**root = [1,2,3,null,5,null,4]
输出:[1,3,4]
解释:
示例 2:
**输入:**root = [1,2,3,4,null,null,null,5]
输出:[1,3,4,5]
解释:

示例 3:
**输入:**root = [1,null,3]
输出:[1,3]
示例 4:
**输入:**root = []
输出:[]
提示:
- 二叉树的节点个数的范围是
[0,100] -100 <= Node.val <= 100
1 | class Solution { |
从前序与中序遍历序列构造二叉树
给定两个整数数组 preorder 和 inorder ,其中 preorder 是二叉树的先序遍历, inorder 是同一棵树的中序遍历,请构造二叉树并返回其根节点。
示例 1:
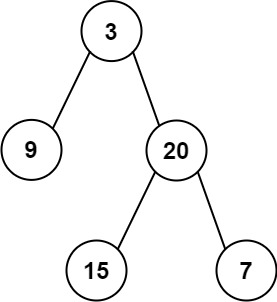
1 | 输入: preorder = [3,9,20,15,7], inorder = [9,3,15,20,7] |
示例 2:
1 | 输入: preorder = [-1], inorder = [-1] |
提示:
1 <= preorder.length <= 3000inorder.length == preorder.length-3000 <= preorder[i], inorder[i] <= 3000preorder和inorder均 无重复 元素inorder均出现在preorderpreorder保证 为二叉树的前序遍历序列inorder保证 为二叉树的中序遍历序列
1 | class Solution { |
路径总和III
给定一个二叉树的根节点 root ,和一个整数 targetSum ,求该二叉树里节点值之和等于 targetSum 的 路径 的数目。
路径 不需要从根节点开始,也不需要在叶子节点结束,但是路径方向必须是向下的(只能从父节点到子节点)。
示例 1:
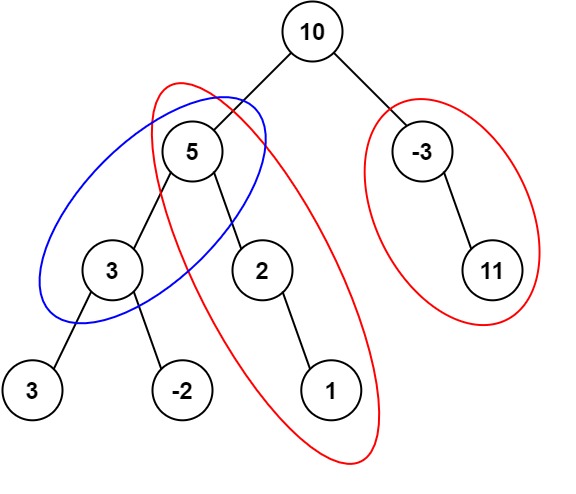
1 | 输入:root = [10,5,-3,3,2,null,11,3,-2,null,1], targetSum = 8 |
示例 2:
1 | 输入:root = [5,4,8,11,null,13,4,7,2,null,null,5,1], targetSum = 22 |
提示:
- 二叉树的节点个数的范围是
[0,1000] -109 <= Node.val <= 109-1000 <= targetSum <= 1000
1 | class Solution { |
二叉树的最近公共祖先
给定一个二叉树, 找到该树中两个指定节点的最近公共祖先。
百度百科中最近公共祖先的定义为:“对于有根树 T 的两个节点 p、q,最近公共祖先表示为一个节点 x,满足 x 是 p、q 的祖先且 x 的深度尽可能大(一个节点也可以是它自己的祖先)。”
示例 1:
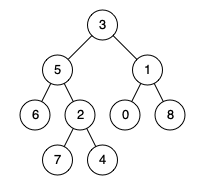
1 | 输入:root = [3,5,1,6,2,0,8,null,null,7,4], p = 5, q = 1 |
示例 2:
1 | 输入:root = [3,5,1,6,2,0,8,null,null,7,4], p = 5, q = 4 |
示例 3:
1 | 输入:root = [1,2], p = 1, q = 2 |
提示:
- 树中节点数目在范围
[2, 105]内。 -109 <= Node.val <= 109- 所有
Node.val互不相同。 p != qp和q均存在于给定的二叉树中。
1 | class Solution { |
二叉树展开为链表
给你二叉树的根结点 root ,请你将它展开为一个单链表:
- 展开后的单链表应该同样使用
TreeNode,其中right子指针指向链表中下一个结点,而左子指针始终为null。 - 展开后的单链表应该与二叉树 先序遍历 顺序相同。
示例 1:
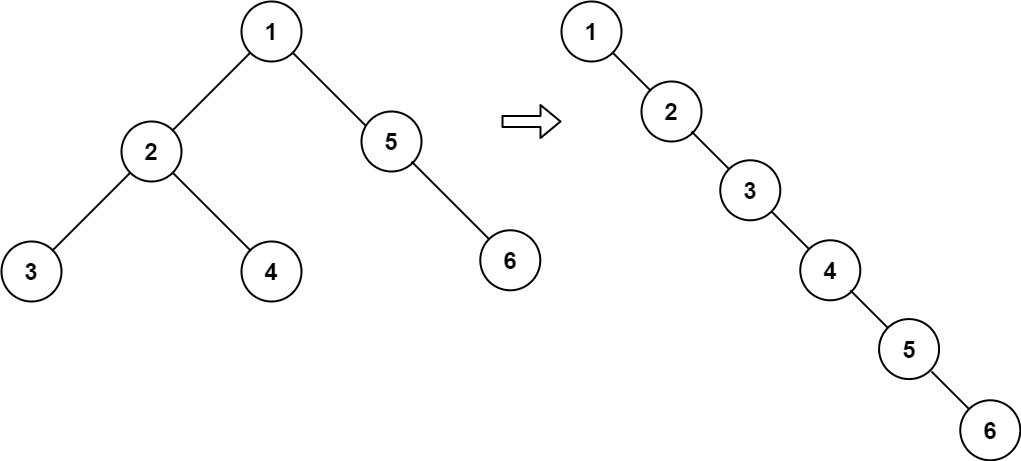
1 | 输入:root = [1,2,5,3,4,null,6] |
示例 2:
1 | 输入:root = [] |
示例 3:
1 | 输入:root = [0] |
提示:
- 树中结点数在范围
[0, 2000]内 -100 <= Node.val <= 100
1 | class Solution { |
二叉树中的最大路径和
二叉树中的 路径 被定义为一条节点序列,序列中每对相邻节点之间都存在一条边。同一个节点在一条路径序列中 至多出现一次 。该路径 至少包含一个 节点,且不一定经过根节点。
路径和 是路径中各节点值的总和。
给你一个二叉树的根节点 root ,返回其 最大路径和 。
示例 1:
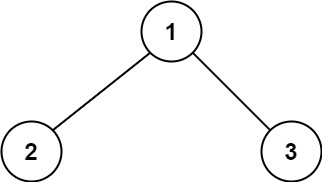
1 | 输入:root = [1,2,3] |
示例 2:
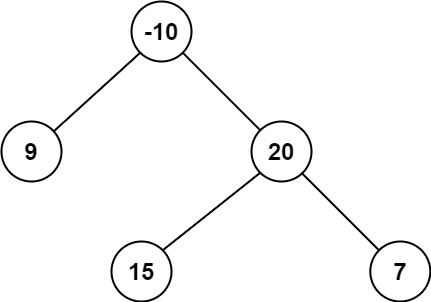
1 | 输入:root = [-10,9,20,null,null,15,7] |
提示:
- 树中节点数目范围是
[1, 3 * 104] -1000 <= Node.val <= 1000
1 | class Solution { |
图论
岛屿数量
给你一个由 '1'(陆地)和 '0'(水)组成的的二维网格,请你计算网格中岛屿的数量。
岛屿总是被水包围,并且每座岛屿只能由水平方向和/或竖直方向上相邻的陆地连接形成。
此外,你可以假设该网格的四条边均被水包围。
示例 1:
1 | 输入:grid = [ |
示例 2:
1 | 输入:grid = [ |
提示:
m == grid.lengthn == grid[i].length1 <= m, n <= 300grid[i][j]的值为'0'或'1'
1 | class Solution { |
腐烂的橘子
在给定的 m x n 网格 grid 中,每个单元格可以有以下三个值之一:
- 值
0代表空单元格; - 值
1代表新鲜橘子; - 值
2代表腐烂的橘子。
每分钟,腐烂的橘子 周围 4 个方向上相邻 的新鲜橘子都会腐烂。
返回 直到单元格中没有新鲜橘子为止所必须经过的最小分钟数。如果不可能,返回 -1 。
示例 1:
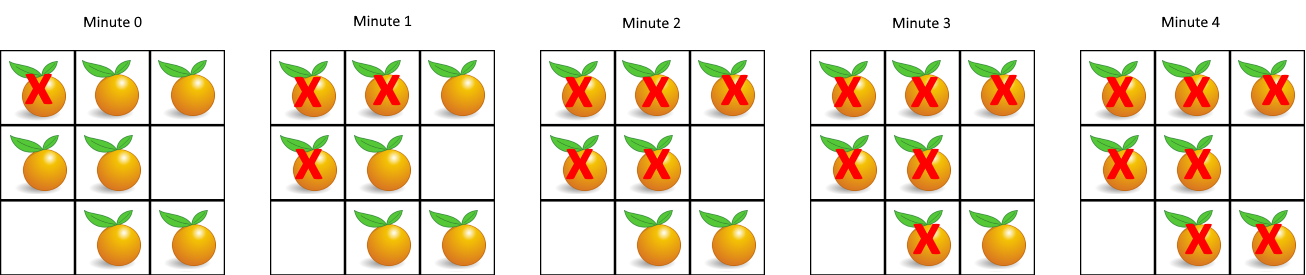
1 | 输入:grid = [[2,1,1],[1,1,0],[0,1,1]] |
示例 2:
1 | 输入:grid = [[2,1,1],[0,1,1],[1,0,1]] |
示例 3:
1 | 输入:grid = [[0,2]] |
提示:
m == grid.lengthn == grid[i].length1 <= m, n <= 10grid[i][j]仅为0、1或2
1 | class Solution { |
动态规划
单词拆分
给你一个字符串 s 和一个字符串列表 wordDict 作为字典。如果可以利用字典中出现的一个或多个单词拼接出 s 则返回 true。
**注意:**不要求字典中出现的单词全部都使用,并且字典中的单词可以重复使用。
示例 1:
1 | 输入: s = "leetcode", wordDict = ["leet", "code"] |
示例 2:
1 | 输入: s = "applepenapple", wordDict = ["apple", "pen"] |
示例 3:
1 | 输入: s = "catsandog", wordDict = ["cats", "dog", "sand", "and", "cat"] |
提示:
1 <= s.length <= 3001 <= wordDict.length <= 10001 <= wordDict[i].length <= 20s和wordDict[i]仅由小写英文字母组成wordDict中的所有字符串 互不相同
1 | public class Solution { |
外层循环判断到以第i个字母结尾能否成功拼接,内层循环利用哈希contains来遍历判断是否能够拼接并更新dp[i]。
最长递增子序列
给你一个整数数组 nums ,找到其中最长严格递增子序列的长度。
子序列 是由数组派生而来的序列,删除(或不删除)数组中的元素而不改变其余元素的顺序。例如,[3,6,2,7] 是数组 [0,3,1,6,2,2,7] 的子序列。
示例 1:
1 | 输入:nums = [10,9,2,5,3,7,101,18] |
示例 2:
1 | 输入:nums = [0,1,0,3,2,3] |
示例 3:
1 | 输入:nums = [7,7,7,7,7,7,7] |
提示:
1 <= nums.length <= 2500-104 <= nums[i] <= 104
1 | class Solution { |
两层循环,外层记录以dp[i]为结尾的最长上升序列,内层循环遍历前面的dp数组动态改变dp[i]。
乘积最大子数组
给你一个整数数组 nums ,请你找出数组中乘积最大的非空连续 子数组(该子数组中至少包含一个数字),并返回该子数组所对应的乘积。
测试用例的答案是一个 32-位 整数。
请注意,一个只包含一个元素的数组的乘积是这个元素的值。
示例 1:
1 | 输入: nums = [2,3,-2,4] |
示例 2:
1 | 输入: nums = [-2,0,-1] |
提示:
1 <= nums.length <= 2 * 104-10 <= nums[i] <= 10nums的任何子数组的乘积都 保证 是一个 32-位 整数
1 | class Solution { |
为什么需要同时维护 maxF 和 minF?
数组中可能包含负数,当遇到负数时,之前的最小乘积(可能是负数)乘以当前负数,结果会变成正数,反而可能成为新的最大乘积。例如:数组
[2, -3, -4],当遍历到-4时,minF[1] = -6(2*-3),-6 * -4 = 24就是当前的最大乘积。为什么用 long 类型?
int 类型的取值范围是
-2^31到2^31-1,多个大数相乘时容易溢出,使用 long 可以临时存储更大的数值,最后再转换回 int,避免计算过程中丢失精度。溢出处理的作用?
(-1 << 31)等价于Integer.MIN_VALUE(即 - 2147483648),当 minF [i] 的计算结果小于这个值时,说明已经溢出 int 的最小值范围,此时重置为当前数,避免后续计算出错。
分割等和子集
给你一个 只包含正整数 的 非空 数组 nums 。请你判断是否可以将这个数组分割成两个子集,使得两个子集的元素和相等。
示例 1:
1 | 输入:nums = [1,5,11,5] |
示例 2:
1 | 输入:nums = [1,2,3,5] |
提示:
1 <= nums.length <= 2001 <= nums[i] <= 100
1 | class Solution { |
创建二维数组 dp,包含 n 行 target+1 列,其中 dp[i][j] 表示从数组的 [0,i] 下标范围内选取若干个正整数(可以是 0 个),是否存在一种选取方案使得被选取的正整数的和等于 j。初始时,dp 中的全部元素都是 false。
在定义状态之后,需要考虑边界情况。以下两种情况都属于边界情况。
如果不选取任何正整数,则被选取的正整数之和等于 0。因此对于所有 0≤i<n,都有 dp[i][0]=true。
当 i==0 时,只有一个正整数 nums[0] 可以被选取,因此 dp[0][nums[0]]=true。
对于 i>0 且 j>0 的情况,如何确定 dp[i][j] 的值?需要分别考虑以下两种情况。
如果 j≥nums[i],则对于当前的数字 nums[i],可以选取也可以不选取,两种情况只要有一个为 true,就有 dp[i][j]=true。
如果不选取 nums[i],则 dp[i][j]=dp[i−1][j];
如果选取 nums[i],则 dp[i][j]=dp[i−1][j−nums[i]]。
如果 j<nums[i],则在选取的数字的和等于 j 的情况下无法选取当前的数字 nums[i],因此有 dp[i][j]=dp[i−1][j]。
状态转移方程如下:
dp[i][j]={
dp[i−1][j] ∣ dp[i−1][j−nums[i]], j≥nums[i]
dp[i−1][j], j<nums[i]
最终得到 dp[n−1][target] 即为答案。
最长有效括号
给你一个只包含 '(' 和 ')' 的字符串,找出最长有效(格式正确且连续)括号 子串 的长度。
左右括号匹配,即每个左括号都有对应的右括号将其闭合的字符串是格式正确的,比如 "(()())"。
示例 1:
1 | 输入:s = "(()" |
示例 2:
1 | 输入:s = ")()())" |
示例 3:
1 | 输入:s = "" |
提示:
0 <= s.length <= 3 * 104s[i]为'('或')'
1 | class Solution { |
遇到左括号 (:直接将当前索引 i 压入栈。
目的:记录左括号的位置,等待后续右括号来匹配。
遇到右括号 ):
① 先执行 stack.pop():
如果栈顶是左括号的索引(比如
(在 0 位),弹出后栈顶会回到基准位置(-1),此时可以计算有效长度。如果栈顶是基准位置(比如连续
1
))
),弹出后栈为空,需要把当前索引压入作为新基准。
② 栈空判断:
栈空 → 说明当前右括号无法匹配,把当前索引
i压入栈,作为新的「无效基准」。栈非空 → 用当前索引
i减去栈顶值,得到以当前右括号结尾的有效括号长度,并更新最大值maxans。
多维动态规划
最小路径和
给定一个包含非负整数的 *m* x *n* 网格 grid ,请找出一条从左上角到右下角的路径,使得路径上的数字总和为最小。
**说明:**每次只能向下或者向右移动一步。
示例 1:
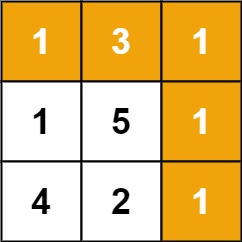
1 | 输入:grid = [[1,3,1],[1,5,1],[4,2,1]] |
示例 2:
1 | 输入:grid = [[1,2,3],[4,5,6]] |
提示:
m == grid.lengthn == grid[i].length1 <= m, n <= 2000 <= grid[i][j] <= 200
1 |
|
先初始化dp数组的第一行第一列,后续当前块最小值都是取min(当前块上边,当前块左边)+当前块。
不同路径
一个机器人位于一个 m x n 网格的左上角 (起始点在下图中标记为 “Start” )。
机器人每次只能向下或者向右移动一步。机器人试图达到网格的右下角(在下图中标记为 “Finish” )。
问总共有多少条不同的路径?
示例 1:

1 | 输入:m = 3, n = 7 |
示例 2:
1 | 输入:m = 3, n = 2 |
示例 3:
1 | 输入:m = 7, n = 3 |
示例 4:
1 | 输入:m = 3, n = 3 |
提示:
1 <= m, n <= 100- 题目数据保证答案小于等于
2 * 109
1 | class Solution { |
与最小路径和类似,不做过多解释。
最长回文子串
给你一个字符串 s,找到 s 中最长的 回文 子串。
示例 1:
1 | 输入:s = "babad" |
示例 2:
1 | 输入:s = "cbbd" |
提示:
1 <= s.length <= 1000s仅由数字和英文字母组成
1 | class Solution { |
判断一个字符串是否为回文字符串,需要根据首尾相同+中间部分是回文串就行了。
最长公共子序列
给定两个字符串 text1 和 text2,返回这两个字符串的最长 公共子序列 的长度。如果不存在 公共子序列 ,返回 0 。
一个字符串的 子序列 是指这样一个新的字符串:它是由原字符串在不改变字符的相对顺序的情况下删除某些字符(也可以不删除任何字符)后组成的新字符串。
- 例如,
"ace"是"abcde"的子序列,但"aec"不是"abcde"的子序列。
两个字符串的 公共子序列 是这两个字符串所共同拥有的子序列。
示例 1:
1 | 输入:text1 = "abcde", text2 = "ace" |
示例 2:
1 | 输入:text1 = "abc", text2 = "abc" |
示例 3:
1 | 输入:text1 = "abc", text2 = "def" |
提示:
1 <= text1.length, text2.length <= 1000text1和text2仅由小写英文字符组成。
1 | class Solution { |
核心在于:dp[i][j] = Math.max(dp[i - 1][j], dp[i][j - 1]);
如果字符不相等,取「不考虑text1当前字符」或「不考虑text2当前字符」的最大值。
编辑距离
给你两个单词 word1 和 word2, 请返回将 word1 转换成 word2 所使用的最少操作数 。
你可以对一个单词进行如下三种操作:
- 插入一个字符
- 删除一个字符
- 替换一个字符
示例 1:
1 | 输入:word1 = "horse", word2 = "ros" |
示例 2:
1 | 输入:word1 = "intention", word2 = "execution" |
提示:
0 <= word1.length, word2.length <= 500word1和word2由小写英文字母组成
1 | class Solution { |
状态转移的三种核心操作:
- 删除:
left = D[i-1][j] + 1→ 删除word1的第i个字符,等价于先把word1前i-1个字符转成word2前j个字符,再删 1 次。 - 插入:
down = D[i][j-1] + 1→ 向word1插入word2的第j个字符,等价于先把word1前i个字符转成word2前j-1个字符,再插 1 次。 - 替换 / 匹配:
left_down→ 若word1[i-1] == word2[j-1],无需操作;若不等,替换word1[i-1]为word2[j-1],加 1 次操作。
状态转移:每一步从删除、插入、替换三种操作中选代价最小的,字符相等时替换操作无需额外代价。
技巧
只出现一次的数字
给你一个 非空 整数数组 nums ,除了某个元素只出现一次以外,其余每个元素均出现两次。找出那个只出现了一次的元素。
你必须设计并实现线性时间复杂度的算法来解决此问题,且该算法只使用常量额外空间。
示例 1 :
**输入:**nums = [2,2,1]
**输出:**1
示例 2 :
**输入:**nums = [4,1,2,1,2]
**输出:**4
示例 3 :
**输入:**nums = [1]
**输出:**1
提示:
1 <= nums.length <= 3 * 104-3 * 104 <= nums[i] <= 3 * 104- 除了某个元素只出现一次以外,其余每个元素均出现两次。
1 | class Solution { |
采用异或方式,相同数异或为0,0与a异或结尾2为a。且满足交换律
多数元素
给定一个大小为 n 的数组 nums ,返回其中的多数元素。多数元素是指在数组中出现次数 大于 ⌊ n/2 ⌋ 的元素。
你可以假设数组是非空的,并且给定的数组总是存在多数元素。
示例 1:
1 | 输入:nums = [3,2,3] |
示例 2:
1 | 输入:nums = [2,2,1,1,1,2,2] |
提示:
n == nums.length1 <= n <= 5 * 104-109 <= nums[i] <= 109- 输入保证数组中一定有一个多数元素。
1 | class Solution { |
颜色分类
给定一个包含红色、白色和蓝色、共 n 个元素的数组 nums ,原地 对它们进行排序,使得相同颜色的元素相邻,并按照红色、白色、蓝色顺序排列。
我们使用整数 0、 1 和 2 分别表示红色、白色和蓝色。
必须在不使用库内置的 sort 函数的情况下解决这个问题。
示例 1:
1 | 输入:nums = [2,0,2,1,1,0] |
示例 2:
1 | 输入:nums = [2,0,1] |
提示:
n == nums.length1 <= n <= 300nums[i]为0、1或2
1 | class Solution { |
把2移到最右边,0移到最左边
下一个排列
整数数组的一个 排列 就是将其所有成员以序列或线性顺序排列。
- 例如,
arr = [1,2,3],以下这些都可以视作arr的排列:[1,2,3]、[1,3,2]、[3,1,2]、[2,3,1]。
整数数组的 下一个排列 是指其整数的下一个字典序更大的排列。更正式地,如果数组的所有排列根据其字典顺序从小到大排列在一个容器中,那么数组的 下一个排列 就是在这个有序容器中排在它后面的那个排列。如果不存在下一个更大的排列,那么这个数组必须重排为字典序最小的排列(即,其元素按升序排列)。
- 例如,
arr = [1,2,3]的下一个排列是[1,3,2]。 - 类似地,
arr = [2,3,1]的下一个排列是[3,1,2]。 - 而
arr = [3,2,1]的下一个排列是[1,2,3],因为[3,2,1]不存在一个字典序更大的排列。
给你一个整数数组 nums ,找出 nums 的下一个排列。
必须** 原地 **修改,只允许使用额外常数空间。
示例 1:
1 | 输入:nums = [1,2,3] |
示例 2:
1 | 输入:nums = [3,2,1] |
示例 3:
1 | 输入:nums = [1,1,5] |
提示:
1 <= nums.length <= 1000 <= nums[i] <= 100
1 | class Solution { |
思路及解法
注意到下一个排列总是比当前排列要大,除非该排列已经是最大的排列。我们希望找到一种方法,能够找到一个大于当前序列的新序列,且变大的幅度尽可能小。具体地:
我们需要将一个左边的「较小数」与一个右边的「较大数」交换,以能够让当前排列变大,从而得到下一个排列。
同时我们要让这个「较小数」尽量靠右,而「较大数」尽可能小。当交换完成后,「较大数」右边的数需要按照升序重新排列。这样可以在保证新排列大于原来排列的情况下,使变大的幅度尽可能小。
以排列 [4,5,2,6,3,1] 为例:
我们能找到的符合条件的一对「较小数」与「较大数」的组合为 2 与 3,满足「较小数」尽量靠右,而「较大数」尽可能小。
当我们完成交换后排列变为 [4,5,3,6,2,1],此时我们可以重排「较小数」右边的序列,序列变为 [4,5,3,1,2,6]。
具体地,我们这样描述该算法,对于长度为 n 的排列 a:
首先从后向前查找第一个顺序对 (i,i+1),满足 a[i]<a[i+1]。这样「较小数」即为 a[i]。此时 [i+1,n) 必然是下降序列。
如果找到了顺序对,那么在区间 [i+1,n) 中从后向前查找第一个元素 j 满足 a[i]<a[j]。这样「较大数」即为 a[j]。
交换 a[i] 与 a[j],此时可以证明区间 [i+1,n) 必为降序。我们可以直接使用双指针反转区间 [i+1,n) 使其变为升序,而无需对该区间进行排序。
寻找重复数
给定一个包含 n + 1 个整数的数组 nums ,其数字都在 [1, n] 范围内(包括 1 和 n),可知至少存在一个重复的整数。
假设 nums 只有 一个重复的整数 ,返回 这个重复的数 。
你设计的解决方案必须 不修改 数组 nums 且只用常量级 O(1) 的额外空间。
示例 1:
1 | 输入:nums = [1,3,4,2,2] |
示例 2:
1 | 输入:nums = [3,1,3,4,2] |
示例 3 :
1 | 输入:nums = [3,3,3,3,3] |
提示:
1 <= n <= 105nums.length == n + 11 <= nums[i] <= nnums中 只有一个整数 出现 两次或多次 ,其余整数均只出现 一次
1 | class Solution { |
这是一个检测链表是否有环的算法,正好符合题意。
说些什么吧!